

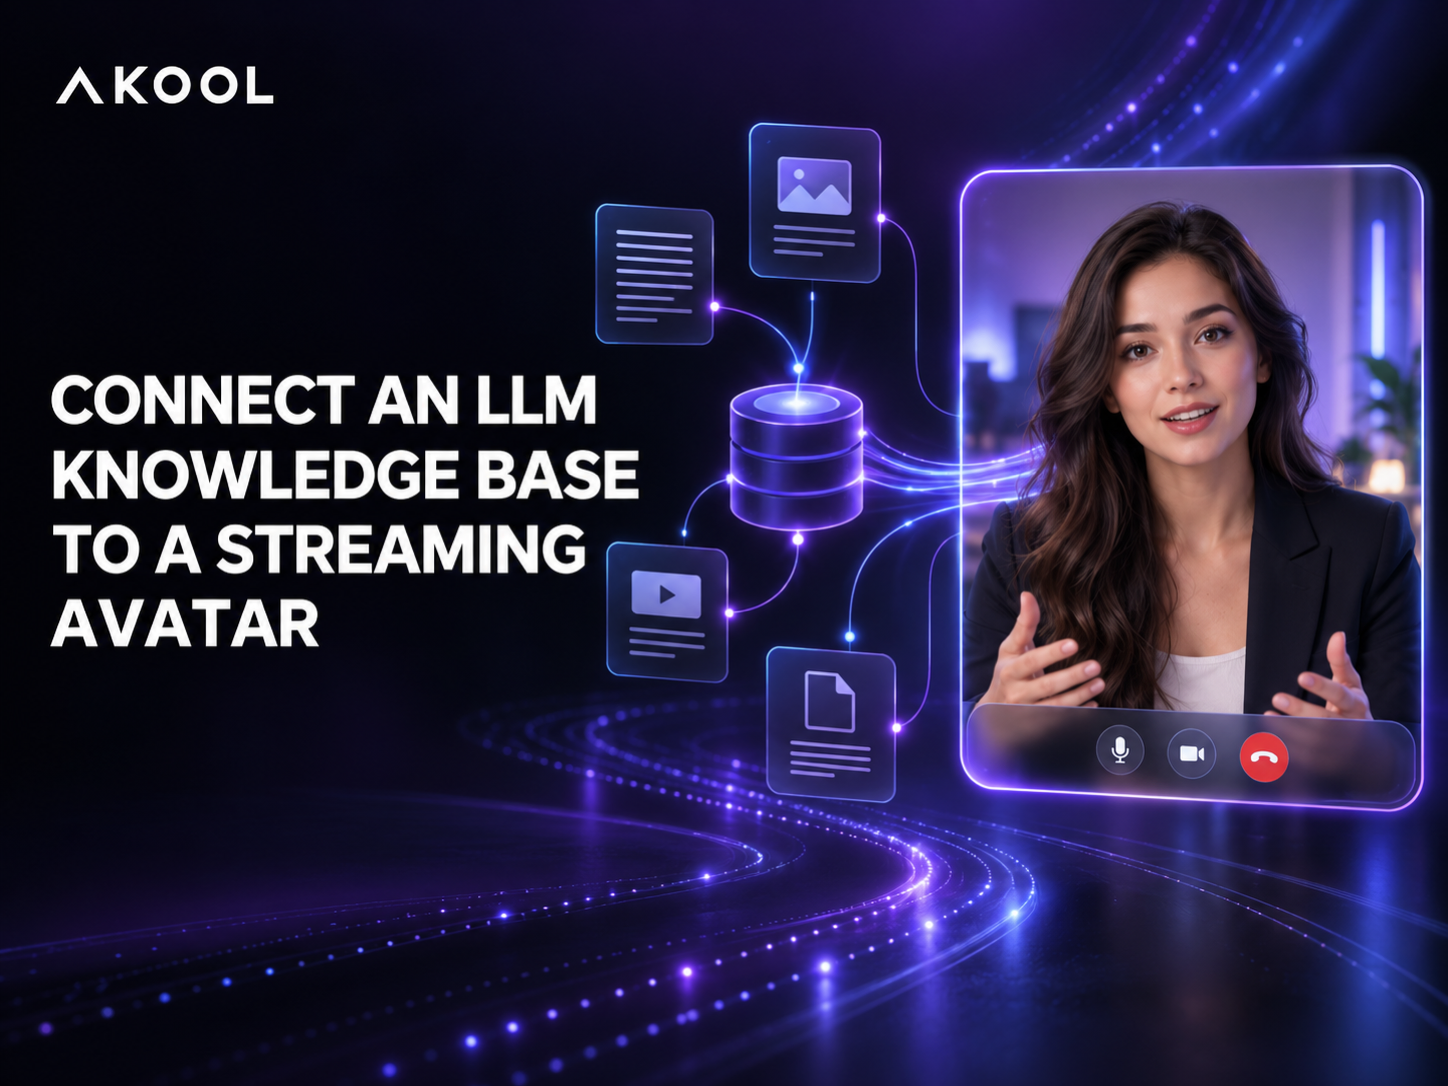

Un avatar de streaming resulta mucho más útil cuando puede responder basándose en la información de su propia empresa en lugar de depender de un modelo genérico. La forma más segura de conectar una base de conocimientos LLM externa es mantener la recuperación, las llamadas al modelo, los permisos y la validación de respuestas en el backend de su aplicación, y luego utilizar un Avatar en streaming de AKOOL como capa de conversación visual en tiempo real.
Este enfoque funciona con un servicio de generación aumentada por recuperación (RAG), una base de datos vectorial, un sistema de búsqueda empresarial o un marco de trabajo de agentes. Además, mantiene las credenciales confidenciales fuera del navegador y le da a su equipo control sobre lo que el avatar tiene permitido decir.
La respuesta corta
Construya la conexión como un flujo de trabajo controlado:
- El cliente habla o escribe en su aplicación.
- Su backend identifica al usuario, recupera el conocimiento permitido y envía el contexto fundamentado a su LLM.
- Su aplicación verifica la respuesta en cuanto a políticas, nivel de confianza y formato.
- La respuesta aprobada se envía a la sesión del avatar en tiempo real para su entrega.
- Los eventos de sesión, las citas, la latencia y los fallos se registran para su monitoreo.
AKOOL también ofrece una opción de base de conocimientos nativa a través del campo knowledge_id cuando se crea una sesión de avatar en vivo. Esto es útil cuando su contenido ya reside en AKOOL. Si utiliza una pila RAG externa, trátela como una integración a nivel de aplicación en lugar de asumir que una base de datos de terceros arbitraria puede pasarse directamente como un ID de conocimiento de AKOOL.
Lo que necesita antes de empezar
Prepare cuatro componentes antes de construir el flujo conversacional:
- Una fuente de conocimiento seleccionada: documentación de productos, políticas, catálogos, artículos de soporte u otro material aprobado.
- Una capa de recuperación y LLM: un servicio que pueda buscar en el contenido permitido y generar una respuesta con un contexto de origen rastreable.
- Un orquestador de backend: el servidor que almacena las credenciales, crea sesiones de avatar, aplica reglas de acceso y coordina la conversación.
- Una interfaz orientada al cliente: la experiencia web o móvil que muestra el avatar, captura la entrada y gestiona los estados de conexión.
Paso 1: Preparar el conocimiento para una recuperación fiable
Las buenas respuestas del avatar comienzan con un buen material de origen. Elimine duplicados, archive instrucciones obsoletas y divida los documentos largos en secciones que conserven el significado. Añada metadatos como producto, región, idioma, audiencia y fecha de vigencia para que el sistema de recuperación pueda filtrar antes de clasificar los resultados.
Decida a qué documentos puede acceder cada usuario. Un visitante público, un cliente autenticado y un empleado interno no deberían recuperar información automáticamente de la misma colección. Aplique esas reglas antes de que el contenido llegue al modelo.
Paso 2: Crear sesiones de avatar en el backend
Utilice un endpoint del lado del servidor para autenticarse con AKOOL y crear la sesión de avatar en vivo. El Creación de sesiones acepta configuraciones como el avatar, la voz, el idioma, la duración, el modo de transmisión y un identificador opcional de base de conocimientos nativa.
Devuelva únicamente la información de sesión de corta duración que el cliente necesita. No exponga un secreto de cliente de AKOOL, una clave de API de LLM ni credenciales de base de datos sin restricciones en el código del navegador. Las mejores prácticas del SDK recomiendan la gestión de sesiones en el backend, el uso de tokens de corta duración, el manejo estructurado de errores y el registro de eventos.
Paso 3: Enrutar cada turno a través de su LLM
Cuando el cliente haga una pregunta, envíe la transcripción o el mensaje escrito a su backend. El backend debe recuperar solo los pasajes autorizados, construir un prompt enfocado e instruir al modelo para que responda basándose en la evidencia proporcionada. Si la evidencia es insuficiente, el modelo debe hacer una pregunta aclaratoria o derivar a un humano en lugar de improvisar.
Antes de la entrega, aplique los controles que requiera su caso de uso. Las comprobaciones comunes incluyen información de identificación personal, temas prohibidos, redacción normativa, longitud máxima de respuesta y disponibilidad de citas. Las respuestas cortas y conversacionales suelen funcionar mejor ante la cámara que los párrafos largos.
Paso 4: Entregar la respuesta a través del avatar
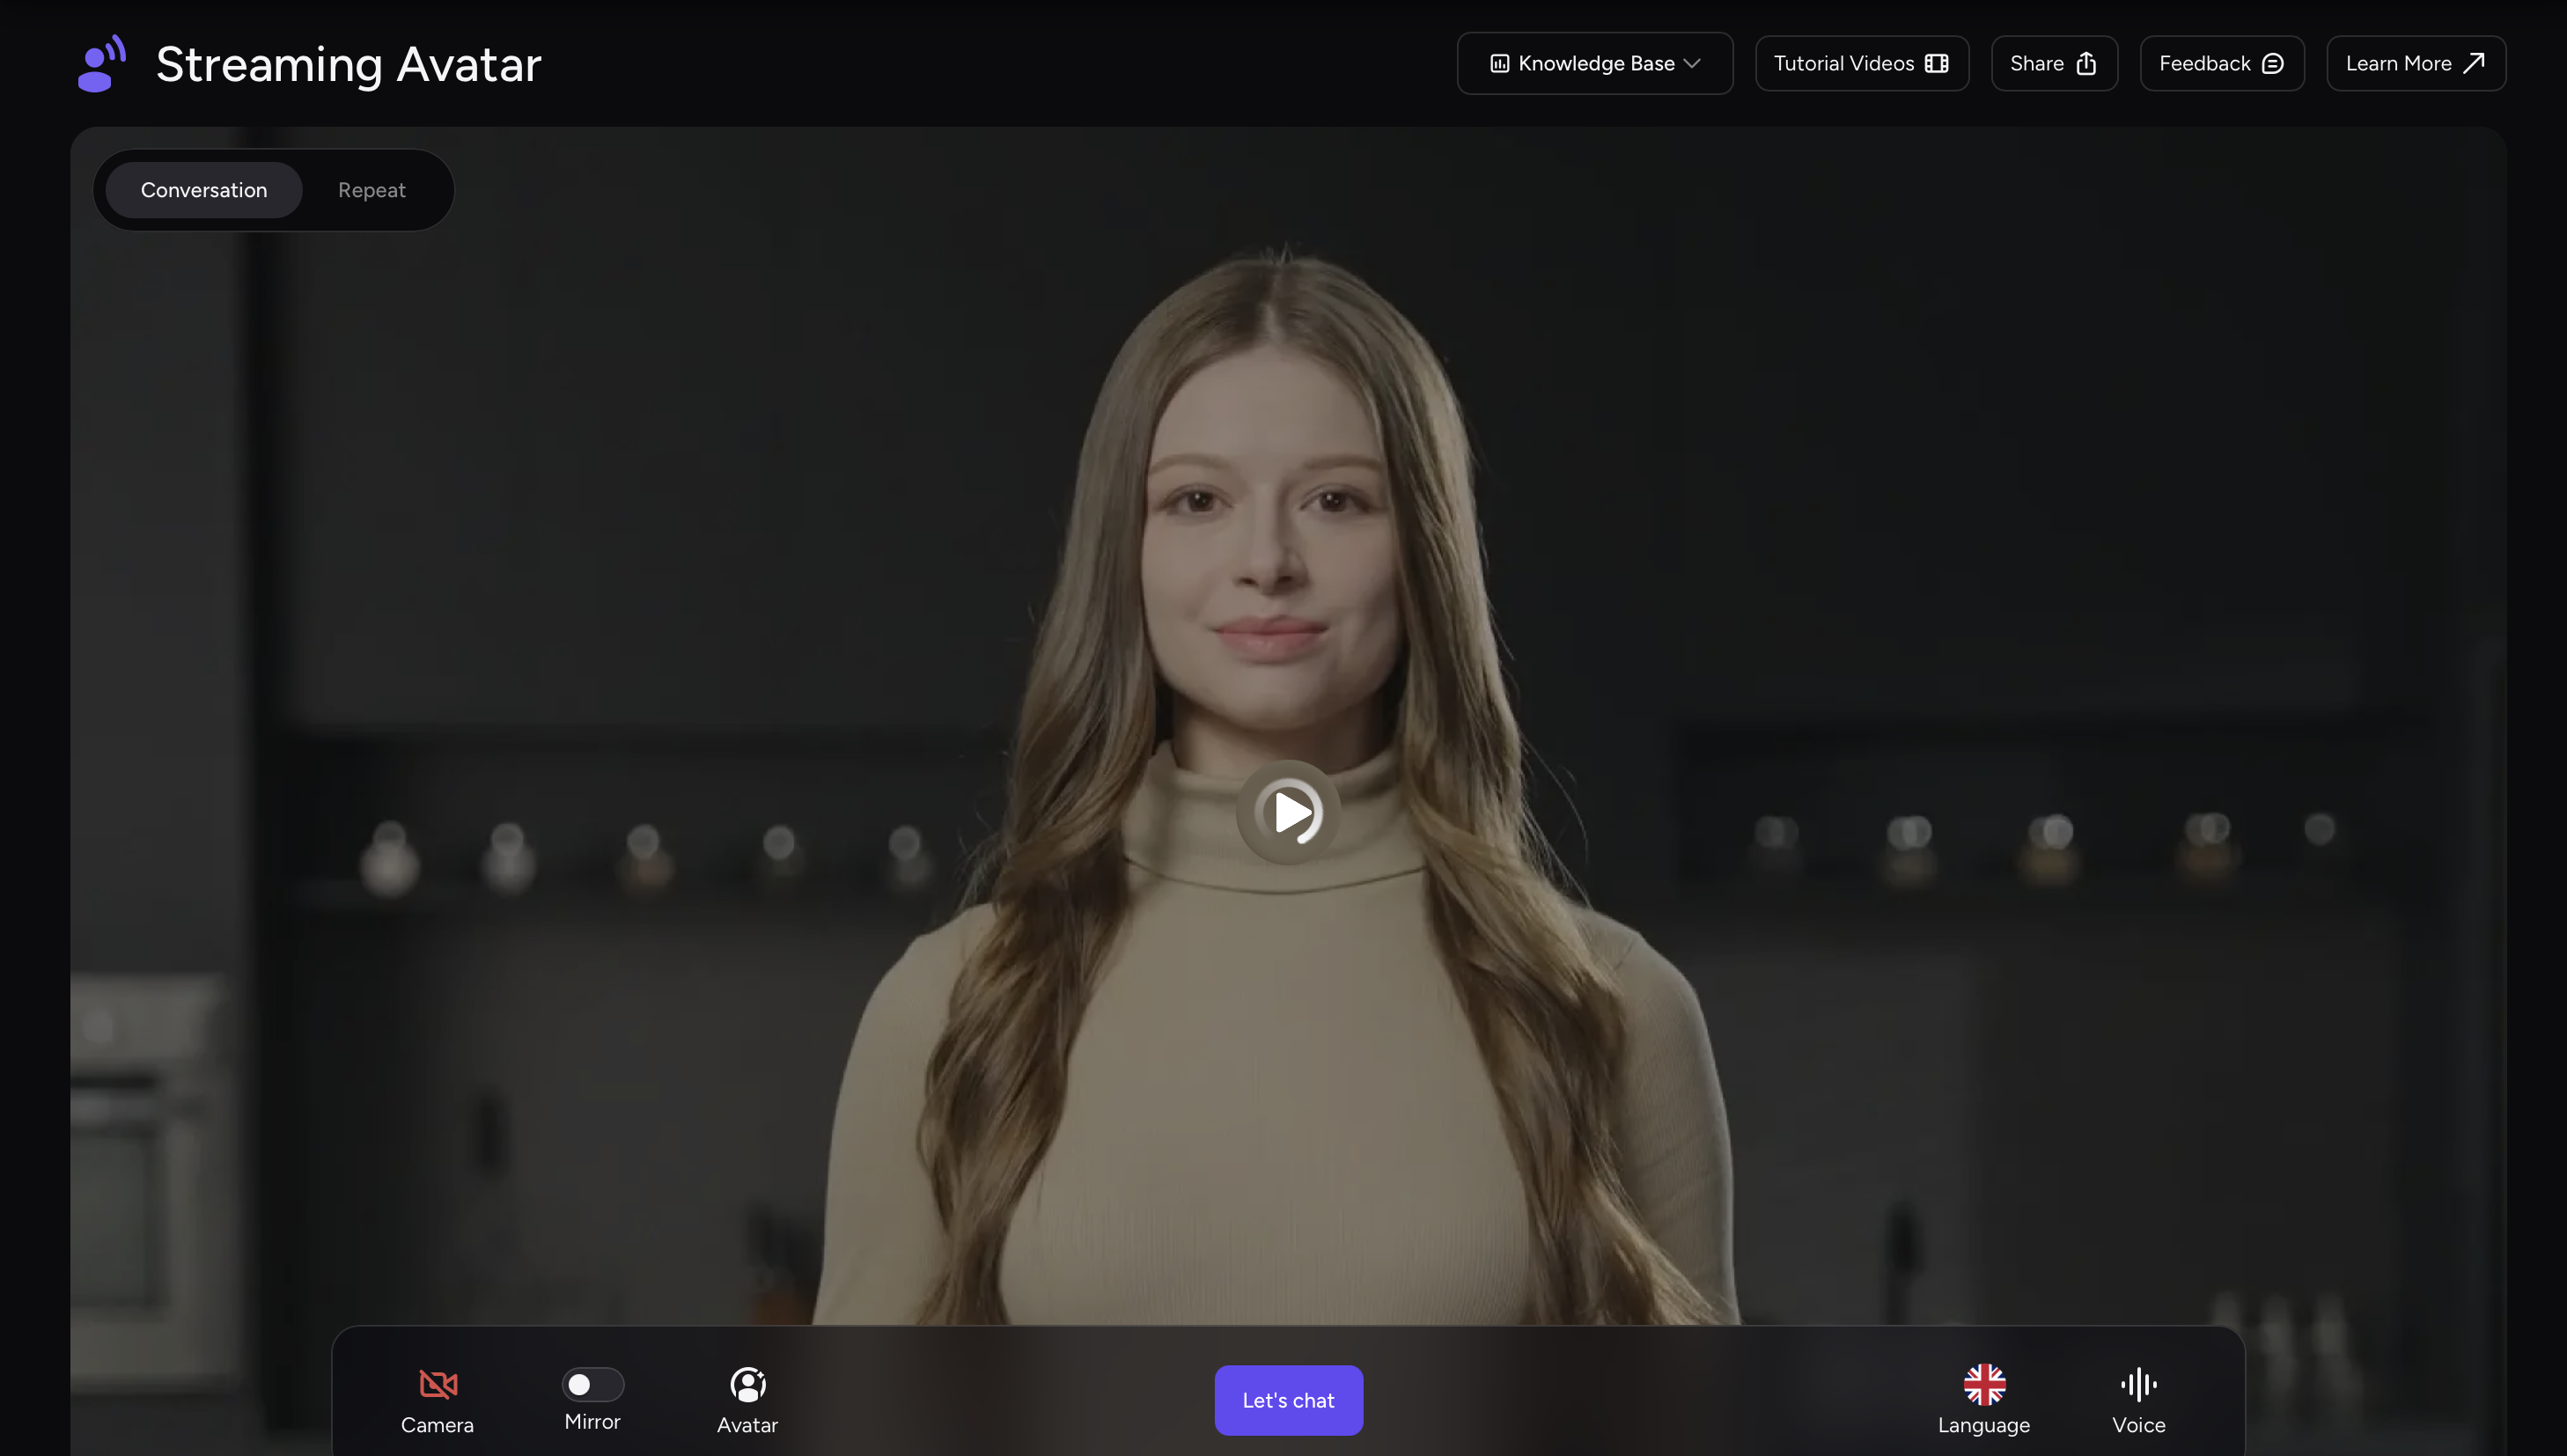
Inicie el avatar en la interfaz del cliente con el SDK de JavaScript de AKOOL. El SDK utiliza comunicaciones en tiempo real y emite eventos de ciclo de vida que su interfaz puede utilizar para obtener información sobre la conexión, el estado del micrófono, el historial de mensajes y la caducidad del token.
Envíe la respuesta aprobada a la sesión activa y deje que el avatar la presente con la voz y el idioma seleccionados. Mantenga la interfaz visual receptiva mientras se realiza la recuperación: muestre un estado de escucha o pensamiento, permita al usuario cancelar y proporcione una alternativa de texto si la conexión en tiempo real se interrumpe.
Una alternativa basada en agentes
Los equipos que ya utilizan un marco de trabajo de agente de voz pueden integrar el avatar en esa arquitectura. AKOOL publica una guía oficial de integración de LiveKit Agent que conecta un agente del lado del servidor con el Streaming Avatar de AKOOL. En ese diseño, el agente puede coordinar el reconocimiento de voz, el LLM, las herramientas externas y el avatar, mientras que su backend mantiene el control de las credenciales y la lógica de negocio.
Cómo probar la integración
No se limite a comprobar si el avatar puede hablar. Utilice un conjunto de preguntas que incluya hechos directos, solicitudes ambiguas, información desactualizada, documentos restringidos, preguntas no admitidas y varios idiomas. Para cada prueba, registre:
- si se recuperaron los documentos correctos;
- si la respuesta se mantuvo fiel a esos documentos;
- el tiempo hasta la primera respuesta visible o audible;
- el comportamiento ante interrupciones, reconexiones y caducidad de tokens;
- si se produjo la alternativa o la transferencia a un agente humano correctamente.
Realice las mismas comprobaciones después de cambios importantes en el contenido, las instrucciones (prompts), el modelo o el SDK. La calidad de la recuperación puede variar incluso cuando la interfaz del avatar no ha cambiado.
Errores comunes que debe evitar
- Llamar al modelo directamente desde el navegador: esto expone las credenciales y debilita el control de acceso.
- Recuperar demasiado contexto: las instrucciones extensas y poco enfocadas aumentan la latencia y pueden reducir la calidad de la respuesta.
- Permitir que el avatar invente una respuesta: defina una ruta explícita para cuando no haya respuesta y para la escalada.
- Ignorar la limpieza de la sesión: cierre las sesiones abandonadas y supervise los fallos en lugar de tratar cada conexión como permanente.
- Medir solo la calidad del modelo: el usuario percibe la recuperación, la generación, la voz, la animación y la latencia de red como un único sistema.
Cree una experiencia de avatar fundamentada
El diseño más fiable separa las responsabilidades: su pila de conocimientos y LLM decide qué decir, su backend aplica la seguridad y las políticas, y el Avatar en streaming de AKOOL entrega la respuesta aprobada como un humano digital en tiempo real. Comience con un caso de uso limitado y bien seleccionado, mida la conversación completa y amplíe solo cuando las rutas de respaldo sean fiables.
Explore el SDK de Avatar en streaming de AKOOL o contacte con AKOOL para hablar sobre una integración empresarial.