

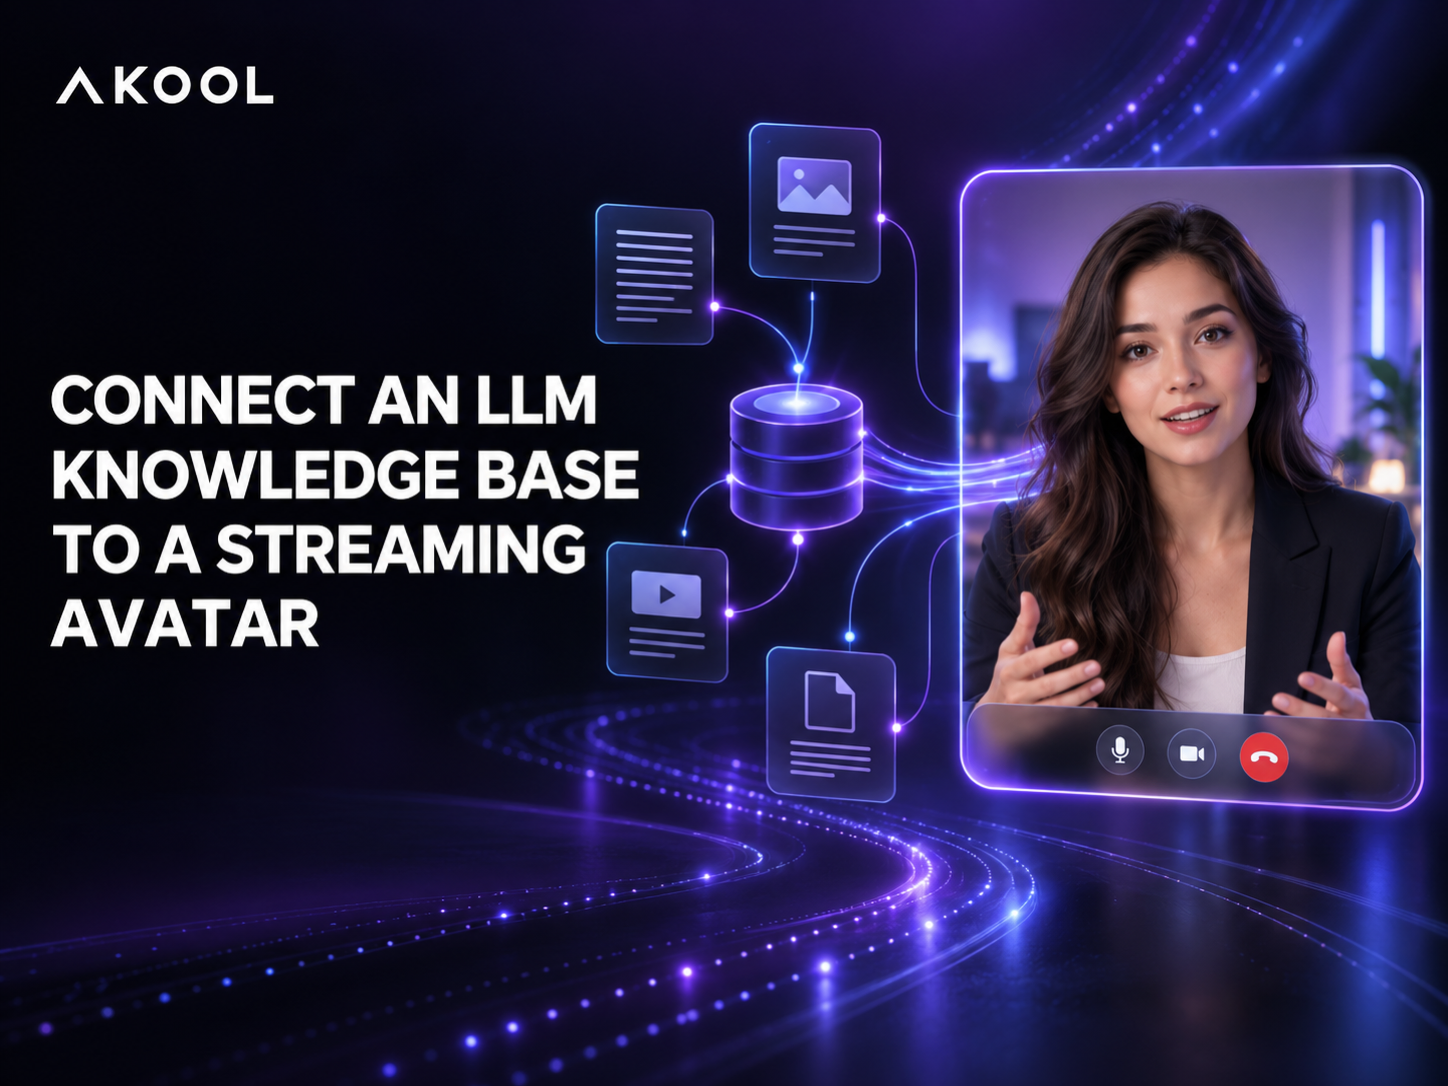

Ein Streaming-Avatar ist weitaus nützlicher, wenn er auf Basis Ihrer eigenen Unternehmensinformationen antworten kann, anstatt sich auf ein allgemeines Modell zu verlassen. Der sicherste Weg, eine externe LLM-Wissensdatenbank anzubinden, besteht darin, den Abruf, die Modellaufrufe, die Berechtigungen und die Validierung der Antworten in Ihrem Anwendungs-Backend zu verwalten und dann Folgendes zu verwenden: AKOOL Streaming-Avatar als visuelle Echtzeit-Konversationsebene.
Dieser Ansatz funktioniert mit einem RAG-Dienst (Retrieval-Augmented Generation), einer Vektordatenbank, einem Enterprise-Suchsystem oder einem Agenten-Framework. Zudem bleiben sensible Zugangsdaten außerhalb des Browsers, und Ihr Team behält die volle Kontrolle darüber, was der Avatar sagen darf.
Kurz gefasst
Bauen Sie die Verbindung als kontrollierte Pipeline auf:
- Der Kunde spricht oder tippt in Ihrer Anwendung.
- Ihr Backend identifiziert den Benutzer, ruft die zulässigen Informationen ab und sendet den fundierten Kontext an Ihr LLM.
- Ihre Anwendung prüft die Antwort auf Richtlinienkonformität, Konfidenz und Formatierung.
- Die freigegebene Antwort wird zur Ausgabe an die Echtzeit-Avatar-Sitzung gesendet.
- Sitzungsereignisse, Quellenangaben, Latenzzeiten und Fehler werden zur Überwachung protokolliert.
AKOOL bietet zudem eine native Wissensdatenbank-Option über das Feld knowledge_id an, wenn eine Live-Avatar-Sitzung erstellt wird. Dies ist nützlich, wenn Ihre Inhalte bereits in AKOOL gespeichert sind. Wenn Sie einen externen RAG-Stack verwenden, behandeln Sie diesen als Integration auf Anwendungsebene, anstatt davon auszugehen, dass eine beliebige Datenbank eines Drittanbieters direkt als AKOOL-Wissens-ID übergeben werden kann.
Was Sie vor dem Start benötigen
Bereiten Sie die folgenden vier Komponenten vor, bevor Sie den Konversationsfluss erstellen:
- Eine kuratierte Wissensquelle: Produktdokumentation, Richtlinien, Kataloge, Support-Artikel oder anderes freigegebenes Material.
- Eine Abruf- und LLM-Ebene: ein Dienst, der die zulässigen Inhalte durchsuchen und eine Antwort mit nachvollziehbarem Quellenkontext generieren kann.
- Ein Backend-Orchestrator: der Server, der Anmeldedaten verwaltet, Avatar-Sitzungen erstellt, Zugriffsregeln anwendet und die Konversation koordiniert.
- Eine kundenorientierte Schnittstelle: das Web- oder Mobile-Erlebnis, das den Avatar anzeigt, Eingaben erfasst und Verbindungsstatus verwaltet.
Schritt 1: Wissen für zuverlässigen Abruf vorbereiten
Gute Antworten des Avatars beginnen mit gutem Ausgangsmaterial. Entfernen Sie Duplikate, archivieren Sie veraltete Anweisungen und unterteilen Sie lange Dokumente in Abschnitte, die ihre Bedeutung bewahren. Fügen Sie Metadaten wie Produkt, Region, Sprache, Zielgruppe und Gültigkeitsdatum hinzu, damit die Suchfunktion die Ergebnisse vor der Rangfolge filtern kann.
Legen Sie fest, auf welche Dokumente jeder Benutzer zugreifen darf. Ein öffentlicher Besucher, ein authentifizierter Kunde und ein interner Mitarbeiter sollten nicht automatisch auf dieselbe Sammlung zugreifen. Setzen Sie diese Regeln durch, bevor der Inhalt das Modell erreicht.
Schritt 2: Avatar-Sitzungen im Backend erstellen
Verwenden Sie einen serverseitigen Endpunkt, um sich bei AKOOL zu authentifizieren und die Live-Avatar-Sitzung zu erstellen. Der Create Session API akzeptiert Einstellungen wie Avatar, Stimme, Sprache, Dauer, Streaming-Modus und optional eine Kennung für die native Wissensdatenbank.
Geben Sie nur die kurzlebigen Sitzungsinformationen zurück, die der Client benötigt. Geben Sie niemals einen AKOOL-Client-Secret, einen LLM-API-Schlüssel oder uneingeschränkte Datenbank-Anmeldedaten im Browser-Code preis. Die SDK-Best-Practices empfehlen eine serverseitige Sitzungsverwaltung, kurzlebige Token, eine strukturierte Fehlerbehandlung und Protokollierung.
Schritt 3: Jeden Dialogschritt über Ihr LLM leiten
Wenn der Kunde eine Frage stellt, senden Sie das Transkript oder die getippte Nachricht an Ihr Backend. Das Backend sollte nur autorisierte Passagen abrufen, eine fokussierte Eingabeaufforderung erstellen und das Modell anweisen, auf Basis der bereitgestellten Nachweise zu antworten. Wenn die Nachweise nicht ausreichen, sollte das Modell eine klärende Frage stellen oder an einen menschlichen Mitarbeiter übergeben, anstatt zu improvisieren.
Wenden Sie vor der Ausgabe die für Ihren Anwendungsfall erforderlichen Kontrollen an. Zu den gängigen Prüfungen gehören personenbezogene Daten, verbotene Themen, regulatorische Formulierungen, die maximale Antwortlänge und die Verfügbarkeit von Quellenangaben. Kurze, konversationelle Antworten funktionieren vor der Kamera meist besser als lange Absätze.
Schritt 4: Die Antwort über den Avatar ausgeben
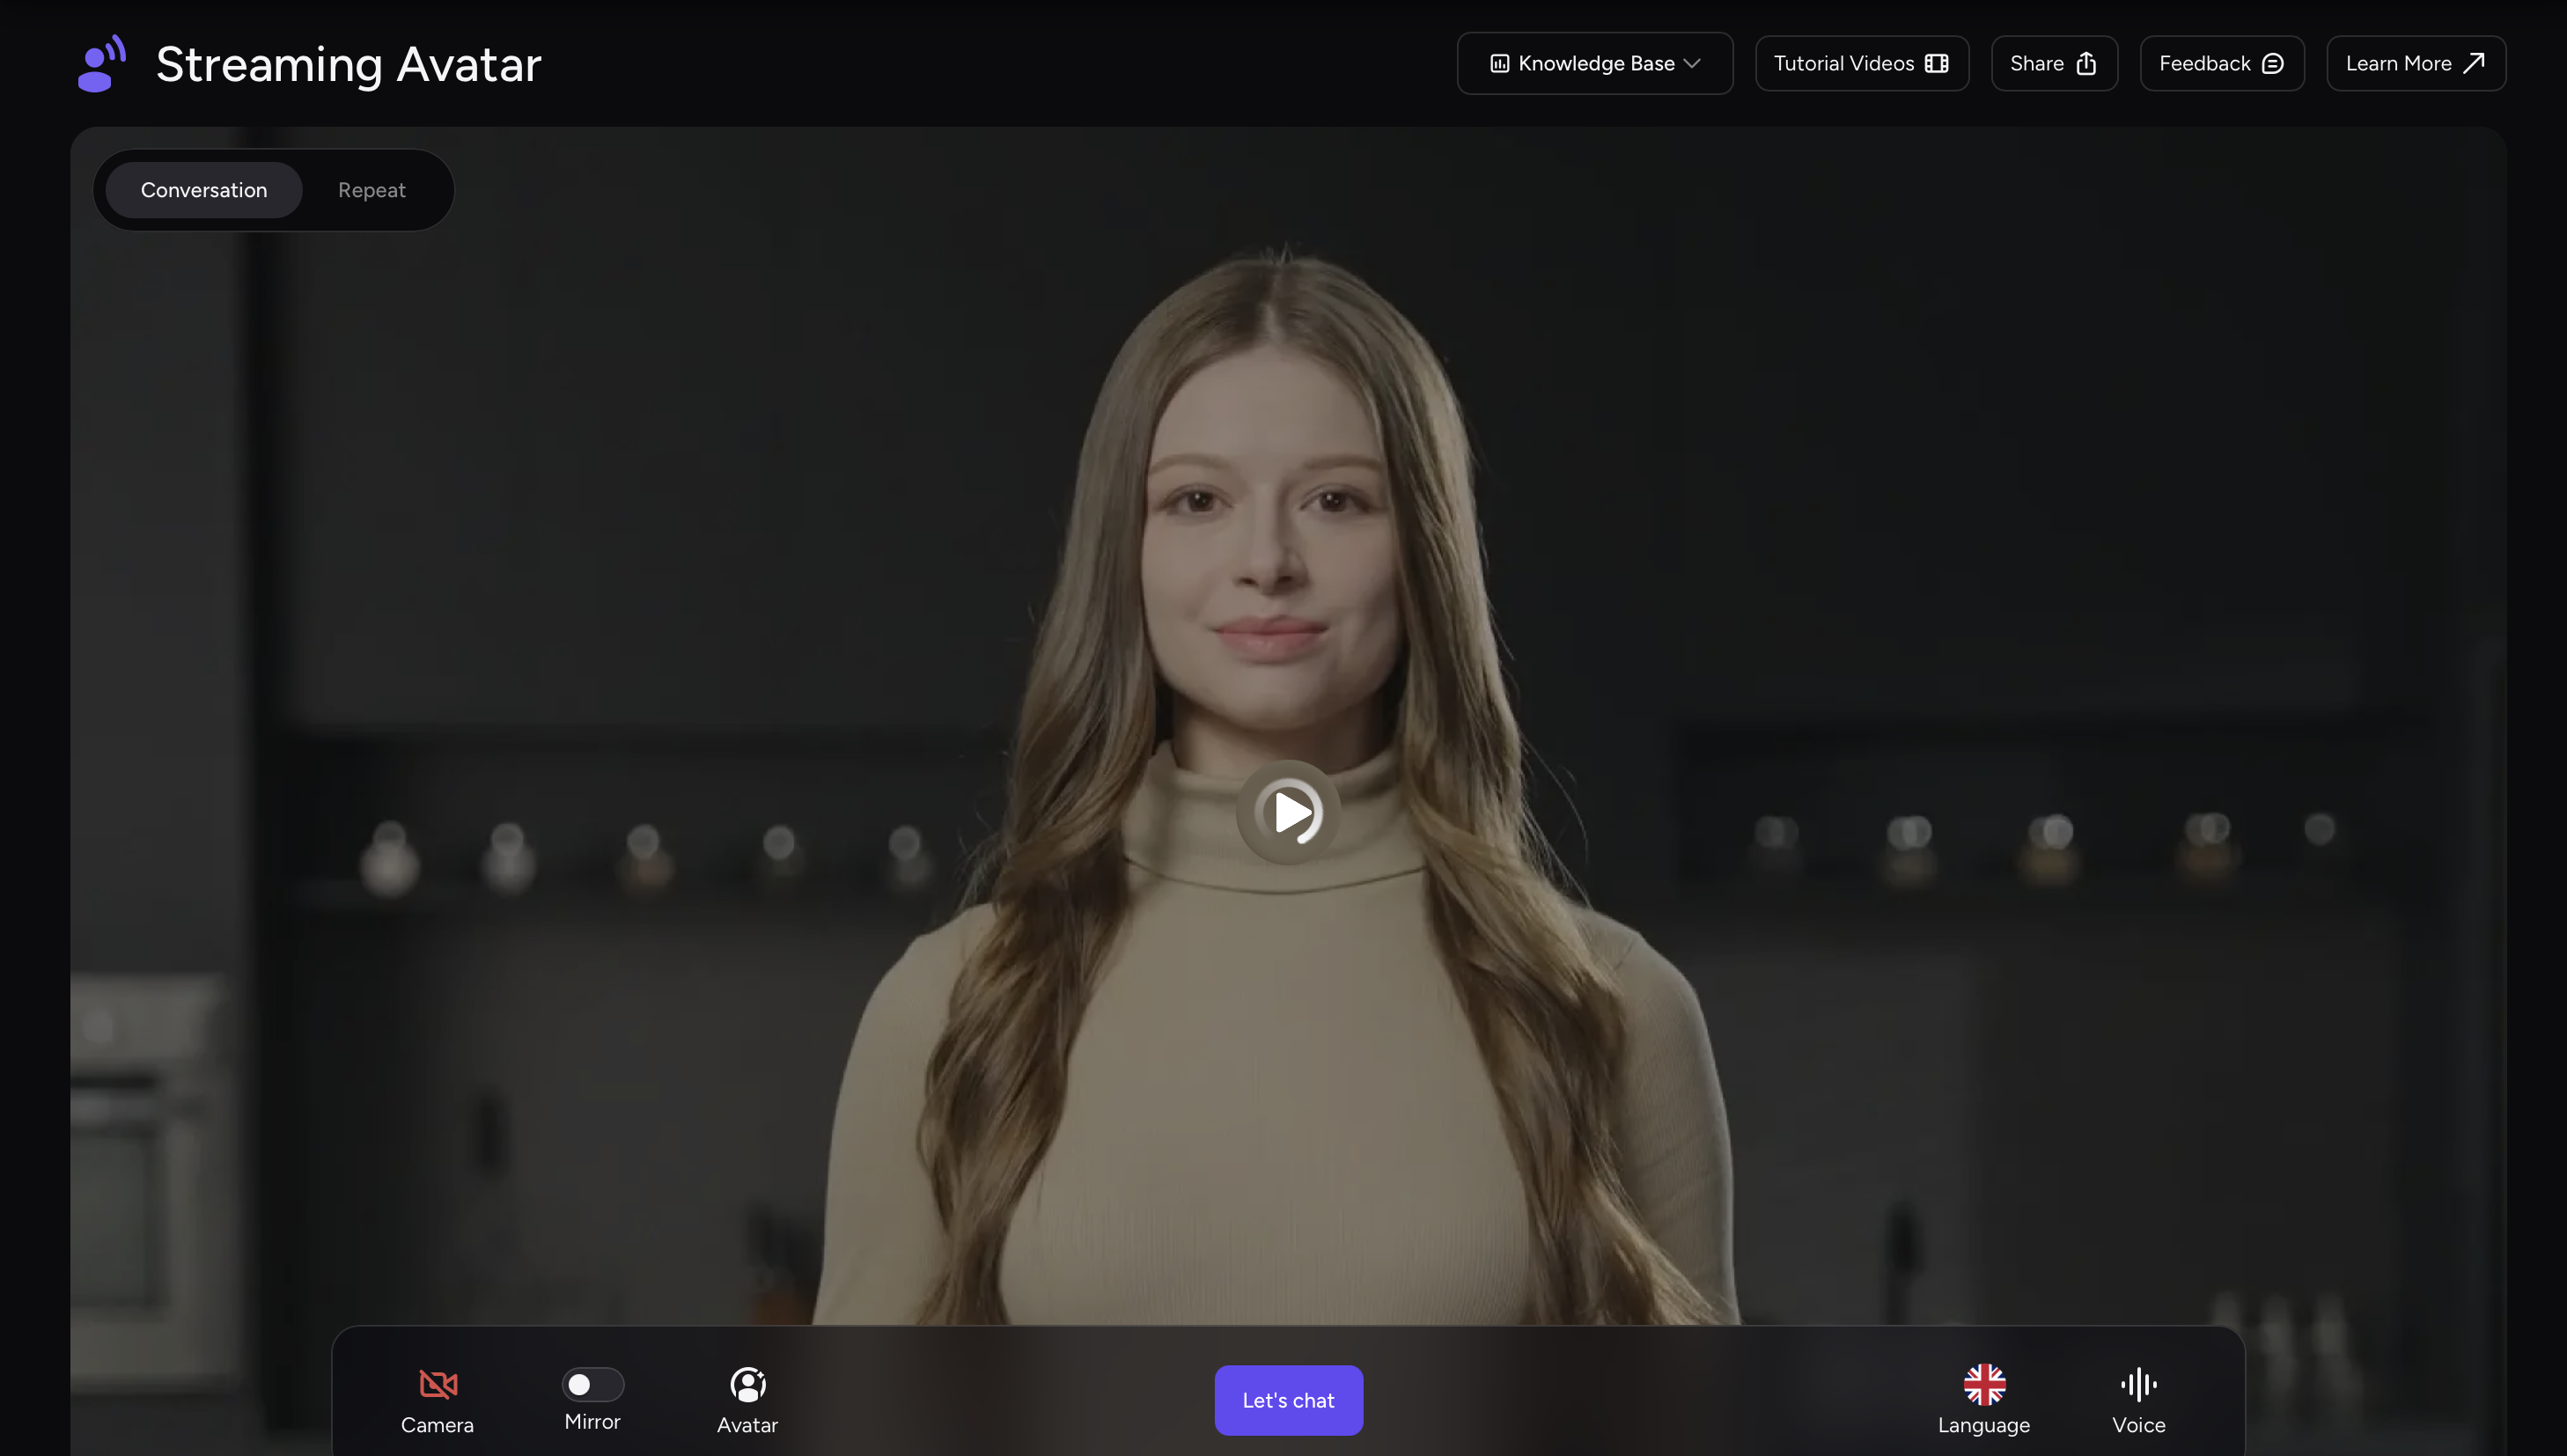
Initialisieren Sie den Avatar in der Kundenschnittstelle mit dem JavaScript SDK von AKOOL. Das SDK nutzt Echtzeitkommunikation und sendet Lebenszyklusereignisse, die Ihre Schnittstelle für Verbindungsfeedback, Mikrofonstatus, Nachrichtenverlauf und Token-Ablauf nutzen kann.
Senden Sie die genehmigte Antwort an die aktive Sitzung und lassen Sie den Avatar sie mit der ausgewählten Stimme und Sprache präsentieren. Halten Sie die visuelle Schnittstelle während des Abrufs reaktionsfähig: Zeigen Sie einen Zuhör- oder Denkstatus an, ermöglichen Sie dem Benutzer den Abbruch und stellen Sie ein Text-Fallback bereit, falls die Echtzeitverbindung unterbrochen wird.
Eine agentenbasierte Alternative
Teams, die bereits ein Voice-Agent-Framework nutzen, können den Avatar in diese Architektur einbinden. AKOOL veröffentlicht einen offiziellen LiveKit Agent-Integrationsleitfaden , der einen serverseitigen Agenten mit dem AKOOL Streaming Avatar verbindet. In diesem Design kann der Agent die Spracherkennung, das LLM, externe Tools und den Avatar koordinieren, während Ihr Backend die Kontrolle über Anmeldedaten und Geschäftslogik behält.
So testen Sie die Integration
Testen Sie mehr als nur die Sprechfähigkeit des Avatars. Verwenden Sie einen Fragenkatalog, der direkte Fakten, mehrdeutige Anfragen, veraltete Informationen, eingeschränkte Dokumente, nicht unterstützte Fragen und mehrere Sprachen umfasst. Protokollieren Sie für jeden Test:
- ob die korrekten Dokumente abgerufen wurden;
- ob die Antwort den Inhalten dieser Dokumente treu blieb;
- die Zeit bis zur ersten sichtbaren oder hörbaren Antwort;
- das Verhalten bei Unterbrechungen, Wiederverbindungen und Token-Ablauf;
- ob das korrekte Fallback oder die Übergabe an einen menschlichen Mitarbeiter erfolgte.
Führen Sie die gleichen Prüfungen nach größeren Änderungen an Inhalten, Prompts, Modellen oder dem SDK durch. Die Qualität des Abrufs kann sich verschlechtern, selbst wenn sich die Avatar-Schnittstelle nicht verändert hat.
Häufige Fehler, die Sie vermeiden sollten
- Direkter Aufruf des Modells aus dem Browser: dies legt Anmeldedaten offen und schwächt die Zugriffskontrolle.
- Abruf von zu viel Kontext: große, unstrukturierte Prompts erhöhen die Latenz und können die Antwortqualität mindern.
- Den Avatar Antworten erfinden lassen: definieren Sie eine explizite Vorgehensweise für Fälle, in denen keine Antwort möglich ist, sowie einen Eskalationspfad.
- Ignorieren der Sitzungsbereinigung: schließen Sie verwaiste Sitzungen und überwachen Sie Fehler, anstatt jede Verbindung als permanent zu betrachten.
- Nur die Modellqualität messen: der Nutzer erlebt Retrieval, Generierung, Sprache, Animation und Netzwerklatenz als ein einziges System.
Entwickeln Sie ein fundiertes Avatar-Erlebnis
Das zuverlässigste Design trennt die Verantwortlichkeiten: Ihr Wissens- und LLM-Stack entscheidet, was gesagt wird, Ihr Backend setzt Sicherheit und Richtlinien durch, und der AKOOL Streaming Avatar liefert die freigegebene Antwort als digitaler Mensch in Echtzeit. Beginnen Sie mit einem eng gefassten, gut kuratierten Anwendungsfall, messen Sie das gesamte Gespräch und erweitern Sie es erst, wenn die Fallback-Pfade zuverlässig funktionieren.
Entdecken Sie das AKOOL Streaming Avatar SDK oder kontaktieren Sie AKOOL um eine Unternehmensintegration zu besprechen.