


Un avatar en streaming devient bien plus utile lorsqu'il peut répondre en utilisant les informations de votre propre entreprise plutôt que de s'appuyer sur un modèle générique. La méthode la plus sûre pour connecter une base de connaissances LLM externe consiste à conserver la récupération, les appels au modèle, les autorisations et la validation des réponses dans le backend de votre application, puis à utiliser un Streaming d'avatar AKOOL en tant que couche de conversation visuelle en temps réel.
Cette approche fonctionne avec un service de génération augmentée par récupération (RAG), une base de données vectorielle, un système de recherche d'entreprise ou un framework d'agent. Elle permet également de garder les identifiants sensibles hors du navigateur et donne à votre équipe le contrôle sur ce que l'avatar est autorisé à dire.
En bref
Construisez la connexion sous forme de pipeline contrôlé :
- Le client parle ou écrit dans votre application.
- Votre backend identifie l'utilisateur, récupère les connaissances autorisées et envoie le contexte étayé à votre LLM.
- Votre application vérifie la réponse en termes de politique, de fiabilité et de formatage.
- La réponse approuvée est envoyée à la session d'avatar en temps réel pour être diffusée.
- Les événements de session, les citations, la latence et les échecs sont enregistrés pour le suivi.
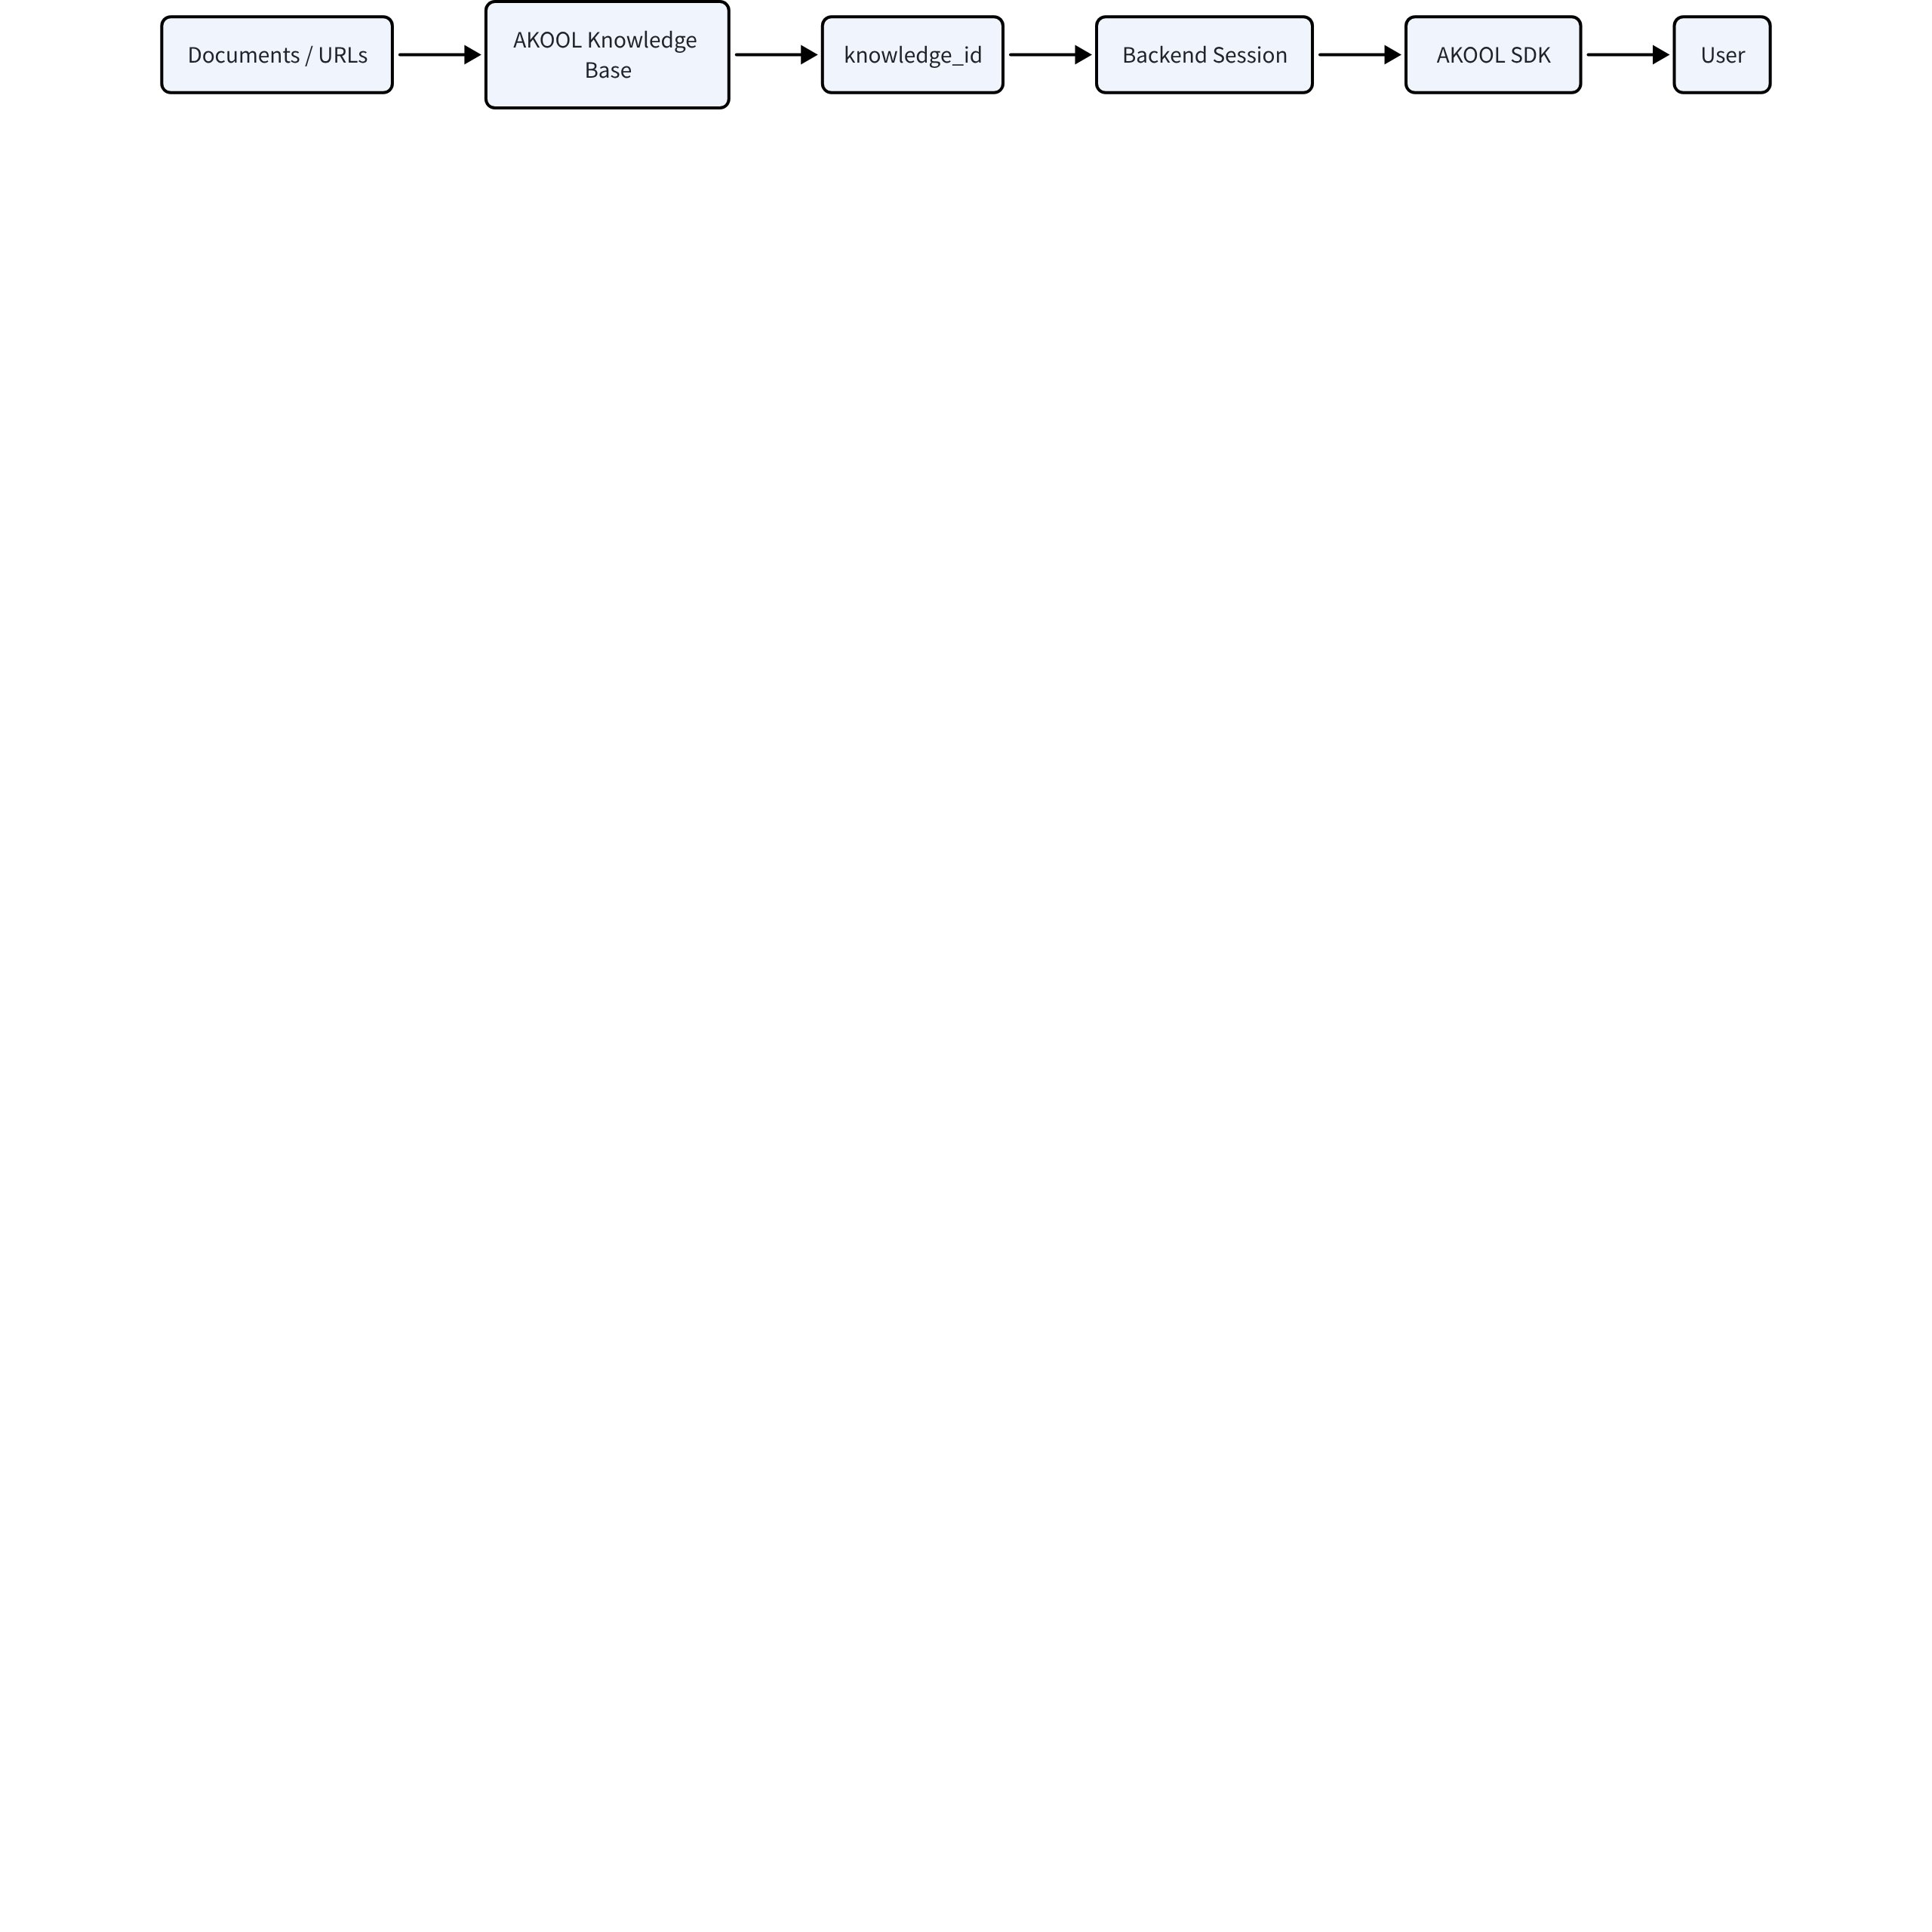
AKOOL propose également une option de base de connaissances native via le champ knowledge_id lors de la création d'une session d'avatar en direct. C'est utile lorsque votre contenu est déjà hébergé dans AKOOL. Si vous utilisez une pile RAG externe, traitez-la comme une intégration au niveau de l'application plutôt que de supposer qu'une base de données tierce arbitraire peut être transmise directement en tant qu'ID de connaissance AKOOL.
Ce dont vous avez besoin avant de commencer
Préparez quatre composants avant de construire le flux conversationnel :
- Une source de connaissances organisée : documentation produit, politiques, catalogues, articles de support ou tout autre matériel approuvé.
- Une couche de récupération et de LLM : un service capable de rechercher dans le contenu autorisé et de produire une réponse avec un contexte source traçable.
- Un orchestrateur backend : le serveur qui gère les identifiants, crée les sessions d'avatar, applique les règles d'accès et coordonne la conversation.
- Une interface client : l'expérience web ou mobile qui affiche l'avatar, capture les entrées et gère les états de connexion.
Étape 1 : Préparer les connaissances pour une récupération fiable
De bonnes réponses de la part d'un avatar commencent par un bon matériel source. Supprimez les doublons, archivez les instructions obsolètes et divisez les longs documents en sections qui préservent le sens. Ajoutez des métadonnées telles que le produit, la région, la langue, le public cible et la date d'effet afin que le moteur de recherche puisse filtrer avant de classer les résultats.
Déterminez les documents auxquels chaque utilisateur peut accéder. Un visiteur public, un client authentifié et un employé interne ne devraient pas automatiquement effectuer des recherches dans la même collection. Appliquez ces règles avant que le contenu n'atteigne le modèle.
Étape 2 : Créer des sessions d'avatar sur le backend
Utilisez un point de terminaison côté serveur pour vous authentifier auprès d'AKOOL et créer la session d'avatar en direct. Le Create Session d'AKOOL accepte des paramètres tels que l'avatar, la voix, la langue, la durée, le mode de streaming et un identifiant de base de connaissances native optionnel.
Ne renvoyez que les informations de session à courte durée de vie dont le client a besoin. N'exposez pas de clé secrète client AKOOL, de clé API LLM ou d'identifiants de base de données non restreints dans le code du navigateur. Les bonnes pratiques du SDK recommandent une gestion des sessions côté backend, des jetons à courte durée de vie, une gestion structurée des erreurs et la journalisation.
Étape 3 : Acheminer chaque interaction via votre LLM
Lorsqu'un client pose une question, envoyez la transcription ou le message saisi à votre backend. Le backend doit récupérer uniquement les passages autorisés, construire une invite ciblée et demander au modèle de répondre à partir des preuves fournies. Si les preuves sont insuffisantes, le modèle doit poser une question de clarification ou transférer la demande à un humain plutôt que d'improviser.
Avant la diffusion, appliquez les contrôles requis par votre cas d'utilisation. Les vérifications courantes incluent les informations personnellement identifiables, les sujets interdits, le libellé réglementaire, la longueur maximale de la réponse et la disponibilité des citations. Des réponses courtes et conversationnelles fonctionnent généralement mieux à l'écran que de longs paragraphes.
Étape 4 : Diffuser la réponse via l'avatar
Initialisez l'avatar dans l'interface client avec le SDK JavaScript d’AKOOL. Le SDK utilise des communications en temps réel et émet des événements de cycle de vie que votre interface peut utiliser pour le retour d'état de la connexion, l'état du microphone, l'historique des messages et l'expiration des jetons.
Envoyez la réponse approuvée à la session active et laissez l'avatar la présenter avec la voix et la langue sélectionnées. Maintenez l'interface visuelle réactive pendant la récupération : affichez un état d'écoute ou de réflexion, permettez à l'utilisateur d'annuler et fournissez une alternative textuelle si la connexion en temps réel est interrompue.
Une alternative basée sur des agents
Les équipes utilisant déjà un framework d'agent vocal peuvent intégrer l'avatar au sein de cette architecture. AKOOL publie un guide d'intégration LiveKit Agent qui connecte un agent côté serveur à l'avatar de streaming AKOOL. Dans cette configuration, l'agent peut coordonner la reconnaissance vocale, le LLM, les outils externes et l'avatar, tandis que votre backend conserve le contrôle des identifiants et de la logique métier.
Comment tester l'intégration
Ne vous contentez pas de vérifier si l'avatar peut parler. Utilisez une série de questions incluant des faits directs, des demandes ambiguës, des informations obsolètes, des documents restreints, des questions non prises en charge et plusieurs langues. Pour chaque test, enregistrez :
- si les documents corrects ont été récupérés ;
- si la réponse est restée fidèle à ces documents ;
- le temps écoulé avant la première réponse visible ou audible ;
- le comportement en cas d'interruptions, de reconnexions et d'expiration de jeton ;
- si le repli ou le transfert vers un humain s'est effectué correctement.
Effectuez les mêmes vérifications après des changements majeurs de contenu, de prompt, de modèle ou de SDK. La qualité de la récupération peut dériver même si l'interface de l'avatar n'a pas changé.
Erreurs courantes à éviter
- Appeler le modèle directement depuis le navigateur : cela expose vos identifiants et affaiblit le contrôle d'accès.
- Récupérer trop de contexte : des prompts volumineux et imprécis augmentent la latence et peuvent réduire la qualité des réponses.
- Laisser l'avatar inventer une réponse : définissez une procédure explicite pour les cas sans réponse et les escalades.
- Ignorer le nettoyage des sessions : fermez les sessions abandonnées et surveillez les échecs au lieu de considérer chaque connexion comme permanente.
- Mesurer uniquement la qualité du modèle : l'utilisateur perçoit la récupération, la génération, la parole, l'animation et la latence réseau comme un seul et même système.
Créer une expérience d'avatar ancrée dans la réalité
La conception la plus fiable consiste à séparer les responsabilités : votre pile de connaissances et de LLM décide de ce qui doit être dit, votre backend assure la sécurité et les politiques, et l'avatar en streaming d'AKOOL délivre la réponse approuvée sous la forme d'un humain numérique en temps réel. Commencez par un cas d'usage restreint et bien défini, mesurez l'intégralité de la conversation et ne développez votre solution qu'une fois que les mécanismes de secours sont fiables.
Explorer le SDK AKOOL Streaming Avatar ou contacter AKOOL pour discuter d'une intégration en entreprise.